未来道具リサーチ / Future Tool
モノモース
ものもーす
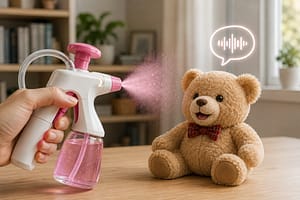
物に吹きかけると、その物が会話できるようになるスプレー型のひみつ道具。
物体認識、対話生成、音声合成、IoT状態取得を統合すれば、特定の物が説明・返答する体験を構築できる。
ACT 1 / DISCOVER
いま、どこまで実現している?
空想の道具を原作どおりに使うための条件と、現代技術で到達している状態に分けて確認します。
総合実現スコア上の未達 42
原作どおりに使うための条件
対象物へスプレーを吹きかけて使用する。
物を話せるようにする
吹きかけた対象物が音声を発し、人と会話できるようにする。
- 現在の状態
- 部分実現
- 実現度
- 45%
対象物認識、対話AI、音声合成、スピーカーを組み合わせた外部的な擬似再現は可能だが、物自体への言語能力付与は未実現。
物の視点を言語化する
対象物の状態や利用履歴を、あたかも物自身の発言として表現する。
- 現在の状態
- 条件付きで実現
- 実現度
- 35%
センサーやデジタルツインに記録された状態を生成AIで自然言語化することで限定的に再現可能。
ACT 2 / UNDERSTAND
総合実現スコア 58 の現在地を、6つの評価軸で見る
6つの評価軸を100点換算し、この道具と公開中の未来道具全体平均を比較します。
基本機能と技術成熟度を6つの評価軸で見ると、最大の未達は機能再現度です。完全実現には、測位性能そのものに加えて、社会で安全に使うための運用設計が重要になります。 噴霧材の化学安全性、誤作動、音量、子どもの誤使用に配慮が必要。 常時カメラ・マイク・利用履歴を扱う場合、同意、最小収集、ローカル処理、保存期間管理が必要。
レーダーチャートは各評価軸を100点換算して比較表示しています。総合実現スコアの配点は評価軸ごとに異なります。
- 機能再現度
- 12 / 35換算 34.3% / 平均 48.9%
- 技術成熟度
- 14 / 20換算 70% / 平均 64.7%
- 原作機能の利用可能性
- 8 / 15換算 53.3% / 平均 47%
- 精度・安定性
- 9 / 10換算 90% / 平均 50.5%
- 導入現実性
- 9 / 10換算 90% / 平均 52.1%
- 社会実装可能性
- 6 / 10換算 60% / 平均 56.3%
平均との差が最も大きいのは精度・安定性。一方、機能再現度は相対的に低く、完全実現に向けた課題として残ります。
Snapshot: 2026-09-04T22:44:17+00:00 / dataset 19 / schema v1.2
Technology Map
どんな技術が、この未来を支えている?


デジタルツイン
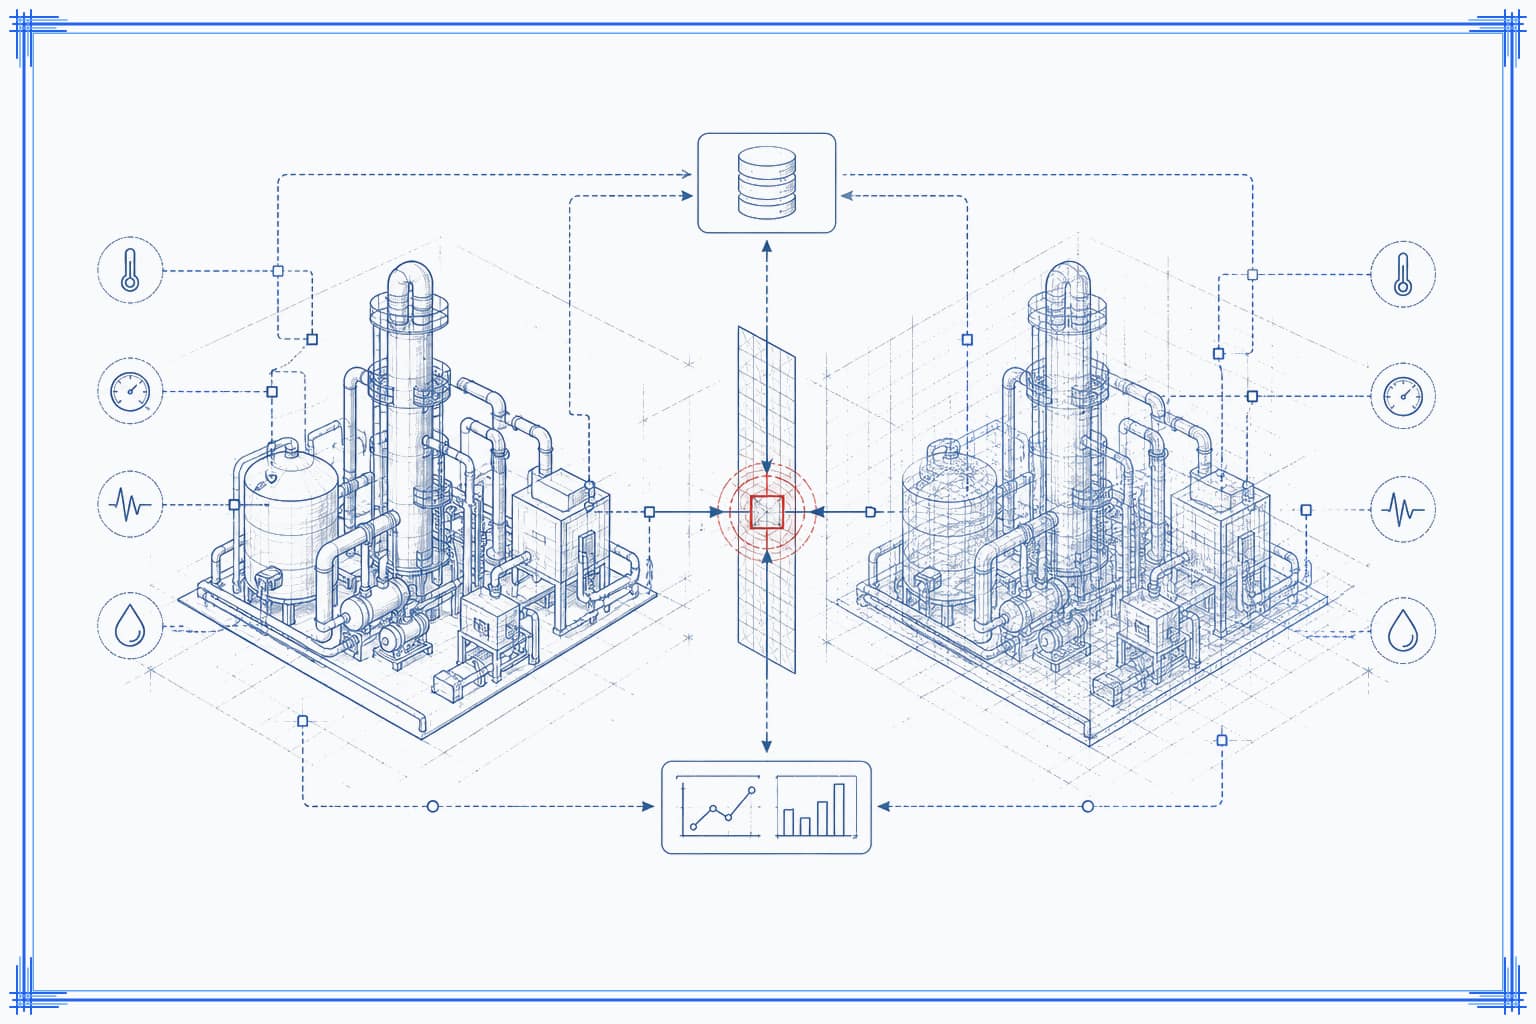
温度、振動、位置、使用回数などを計測し、対象物の状態をデジタルに表現する。
- 似ている点
- 物の状態や履歴を一人称の発言へ変換する材料になる。
- 違う点
- 計測できる項目に限られ、物の主観や感情は取得できない。
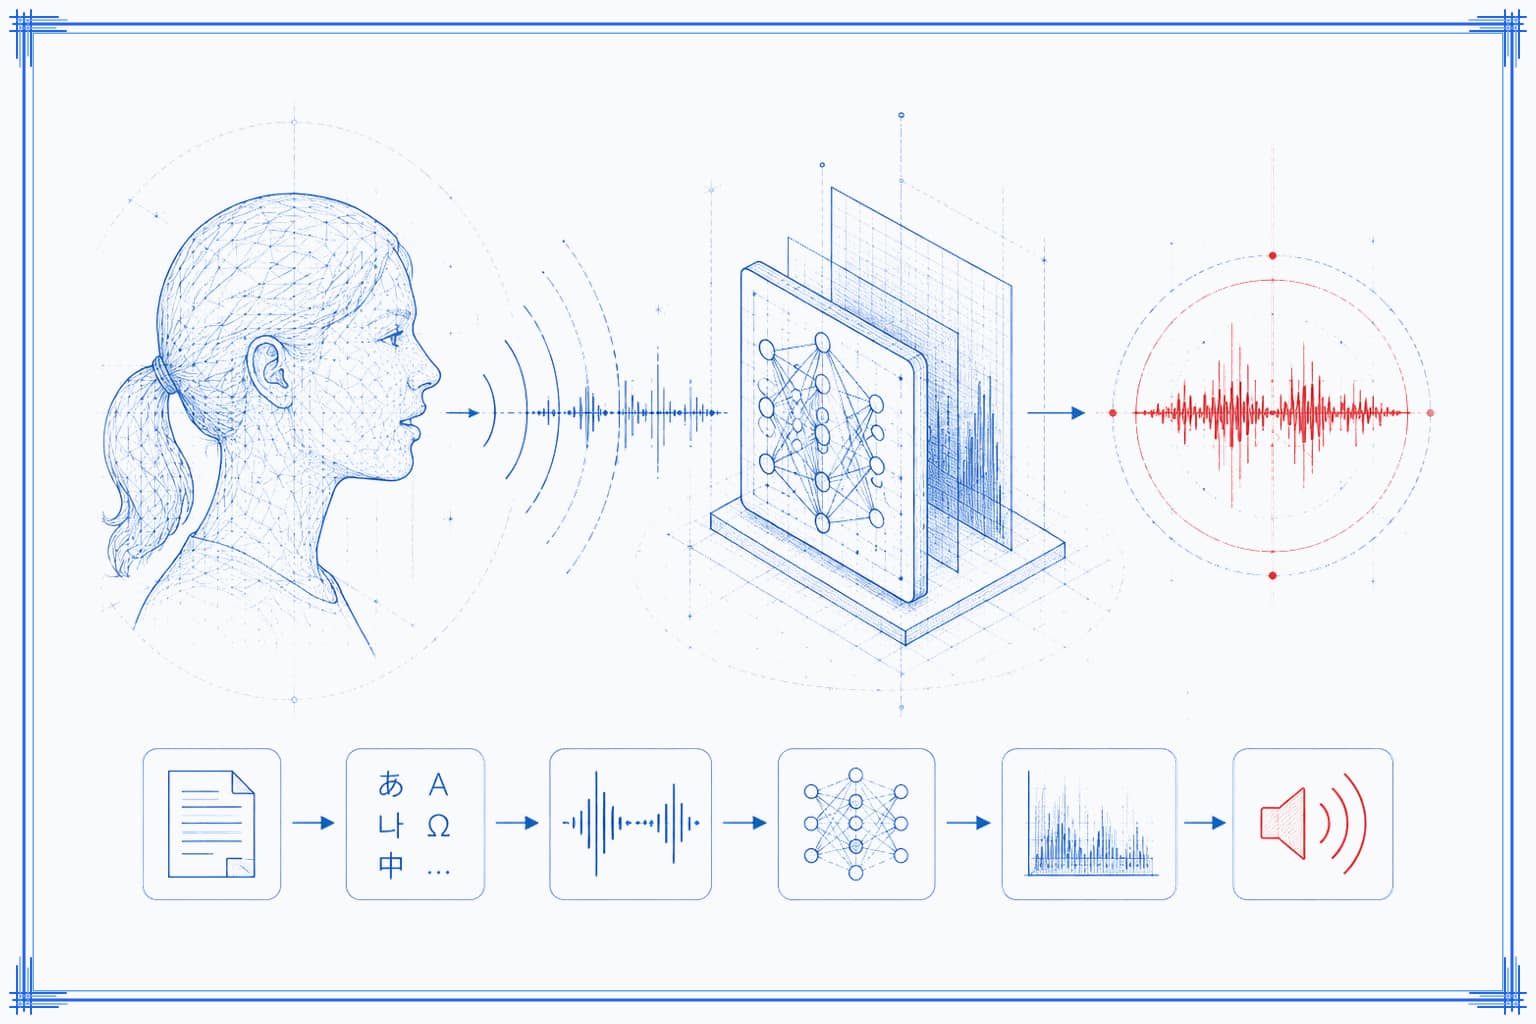
音声合成
テキストから自然な音声を生成し、スピーカーから再生する技術。
- 似ている点
- 対象物が実際に声を出しているような体験を作れる。
- 違う点
- 発声源は外付けスピーカーや端末であり、物体そのものの声ではない。
対話AI
物の状態や視点を会話として表現できる。
- 似ている点
- 物の状態や視点を会話として表現できる。
- 違う点
- 物自体の意識ではなく観測データから生成する。
追加の技術解説
オープン語彙物体検出・視覚言語モデル
画像内の幅広い物体を自然言語語彙で認識・位置特定する技術。
マルチモーダル対話AI
画像情報と外部知識を組み合わせ、質問応答や説明を生成するAI。
ニューラル音声合成
テキストから自然な音声を生成し、スピーカーから再生する技術。
IoTセンサーとデジタルツイン
温度、振動、位置、使用回数などを計測し、対象物の状態をデジタルに表現する。
Build Path
完全実現するなら、どう作る?
カメラで対象物を認識し、センサー情報と対話AIを統合して、近接スピーカーから物の一人称音声を再生する。
物が話しているように感じられる双方向体験。
RFIDやQRコードで物を識別し、登録済みのキャラクター設定と保守情報を音声で案内する。
展示物、家電、教材などが説明する体験。
追加で必要な技術条件
- 低消費電力の薄型センサー・スピーカー
- 高精度な物体状態推定
- 出典を示す低幻覚対話AI
- 安全なオンデバイス音声処理
Bottlenecks
完全実現まで、あと何が足りない?
ここでは点数の内訳ではなく、完全実現に向けて残る未解決課題を定性的に整理します。
技術課題
- 物の本当の状態を知る難しさ 外観だけでは内部状態や履歴を判定できず、センサーやデータ連携が必要。
- 擬似人格と実体の混同 生成AIの発言は対象物自身の意思ではなく、設計者が与えたモデルとデータの出力。
- スプレー型フォームファクター 計算、通信、音響、電源を安全な噴霧膜だけで実装する技術は未成熟。
安全性
噴霧材の化学安全性、誤作動、音量、子どもの誤使用に配慮が必要。
コスト
対象ごとのセンサー、識別子、スピーカー、知識登録、保守コストが発生する。
プライバシー
常時カメラ・マイク・利用履歴を扱う場合、同意、最小収集、ローカル処理、保存期間管理が必要。
超低消費電力の薄型会話インターフェース
センサー、通信、音響出力を薄いラベル状に統合する。
安全な塗布型電子回路・センサー
日用品へ安全に吹き付けられ、識別や簡易センシングを行う機能性膜。
Technology Evolution
技術の歩みと実現への道
Technology Timeline
物が話す技術への歩み
確認済み事実
音声合成・物体認識・対話AI・デジタルツインの統合
-
01社会実装 確認済み 高 出典 1件
IoTとデジタルツインの普及
物理的な対象物の状態をセンサーで取得し、デジタル空間で表現する実装が拡大。
-
02研究 確認済み 高 出典 2件
大規模視覚言語モデルの進展
画像内容を自然言語で説明・質問応答するモデルが急速に発展。
-
03研究 確認済み 中 出典 1件
Pix2Seqによる物体検出の言語モデル化
物体検出を画像条件付きの言語モデリングとして扱う研究が公開された。
-
04研究 確認済み 高 出典 1件
F-VLM研究紹介
凍結した視覚言語モデルを用いたオープン語彙物体検出が紹介された。
-
05その他 暫定 高 出典 4件
既存要素の統合で擬似的な物の会話が可能
カメラ、対話AI、音声合成、IoTを組み合わせた限定用途の実装が可能。
Realization Roadmap
編集部予測モノモース実現ロードマップ
外部装置による擬似会話から薄型インターフェースへ
既存技術の統合で限定的な代替体験は実装可能。
-
01製品 可能性が高い 予測総合実現スコア 68 信頼度 85%
スマートフォン型プロトタイプ
対象物を撮影すると、登録情報と生成AIを使って物の一人称で会話する。
必要なブレークスルー
- 根拠追跡型の物体対話AI
予測根拠
既存APIと端末で構築可能。
-
02技術 実現可能性あり 予測総合実現スコア 75 信頼度 65%
貼付型センサーラベルとの統合
物の状態や履歴を取得する薄型センサーと音声対話を統合。
必要なブレークスルー
- 超低消費電力の薄型会話インターフェース
予測根拠
印刷センサーと低消費電力通信の進展を前提。
-
03技術 不確実 予測総合実現スコア 82 信頼度 40%
塗布型識別・センシング膜
安全な塗布材料に識別、簡易センシング、無線通信機能を持たせる。
必要なブレークスルー
- 安全な塗布型電子回路・センサー
- 小型エネルギーハーベスティング
予測根拠
印刷・フレキシブル電子回路とエネルギーハーベスティングの大幅な進展が必要。
-
04完全実現 科学的に困難 予測総合実現スコア 90 信頼度 20%
任意の物への自然な会話付与
事前登録の少ない対象物でも、状態に根ざした会話を安全に生成する。
必要なブレークスルー
- 根拠追跡型の物体対話AI
- 安全な塗布型電子回路・センサー
- 小型エネルギーハーベスティング
予測根拠
物自身の意識付与は対象外であり、外部システムによる高度な擬似再現として予測。
ロードマップは、現在の研究・製品・社会動向を基にした編集部予測です。将来の実現を保証するものではありません。
Future Breakthroughs
実現に必要なブレークスルー
超低消費電力の薄型会話インターフェース
センサー、通信、音響出力を薄いラベル状に統合する。
安全な塗布型電子回路・センサー
日用品へ安全に吹き付けられ、識別や簡易センシングを行う機能性膜。
根拠追跡型の物体対話AI
センサーデータと検証済み知識だけに発言を接地し、推測と事実を明確に区別する。
小型エネルギーハーベスティング
光、振動、無線電力から薄型デバイスの待機電力を得る。
ACT 3 / IMAGINE
この未来が実現したら、何が変わる?
短期的には展示、教育、スマートホーム、保守案内で普及し、長期的には印刷センサーやエッジAIの進歩で対象物へ貼付・塗布できるインターフェースへ近づく。
- 物を話せるようにするが日常の選択肢になります
- 物の視点を言語化するが日常の選択肢になります
常時カメラ・マイク・利用履歴を扱う場合、同意、最小収集、ローカル処理、保存期間管理が必要。
Story & Ideas
物語と未来を考える
原作で解決する問題
本来は話せない物から情報や本音を聞き出し、対話を可能にする。
作中での使われ方
画像資料では、物に吹きかけると物がしゃべれるようになると説明されている。
失敗・意外な展開
画像資料だけでは確認できない。
なぜ魅力的なのか
身の回りの物が見てきた出来事や状態を語るという、アニミズム的な想像を直接体験に変える点。
もし実現したら
廃棄物や道具の状態を直感的に理解できる一方、物が語った内容を事実と誤認する危険が生まれる。
考えてみたい問い
物が話すとき、その発言の責任は物、所有者、AI開発者の誰が負うべきだろうか。
Related Approaches
同じ技術で近づく道具
共通する技術をもとに、同じアプローチで実現に近づく道具を紹介しています。
Organizations
関連企業・研究機関
関連技術・エコシステム
デジタルツインを通じて関連
デジタルツインを通じて関連
音声合成を通じて関連
音声合成を通じて関連
音声合成を通じて関連
対話AIを通じて関連
対話AIを通じて関連
Evidence & Sources
根拠資料と調査情報
F-VLM: Open-vocabulary object detection upon frozen vision and language models
オープン語彙物体検出の研究紹介。
Autonomous visual information seeking with large language models
視覚情報とLLM、外部知識を組み合わせた質問応答研究。
AVSpeechSynthesizer
端末上の音声合成API公式資料。
Digital Twins
デジタルツイン技術に関するNISTの公式情報。
US10967520B1 Multimodal object identification
マルチモーダルな対象物識別に関する特許情報。
Pix2Seq: A New Language Interface for Object Detection
物体検出を言語モデリングとして扱う研究紹介。