未来道具リサーチ / Future Tool
ほんやくコンニャク
ほんやくこんにゃく
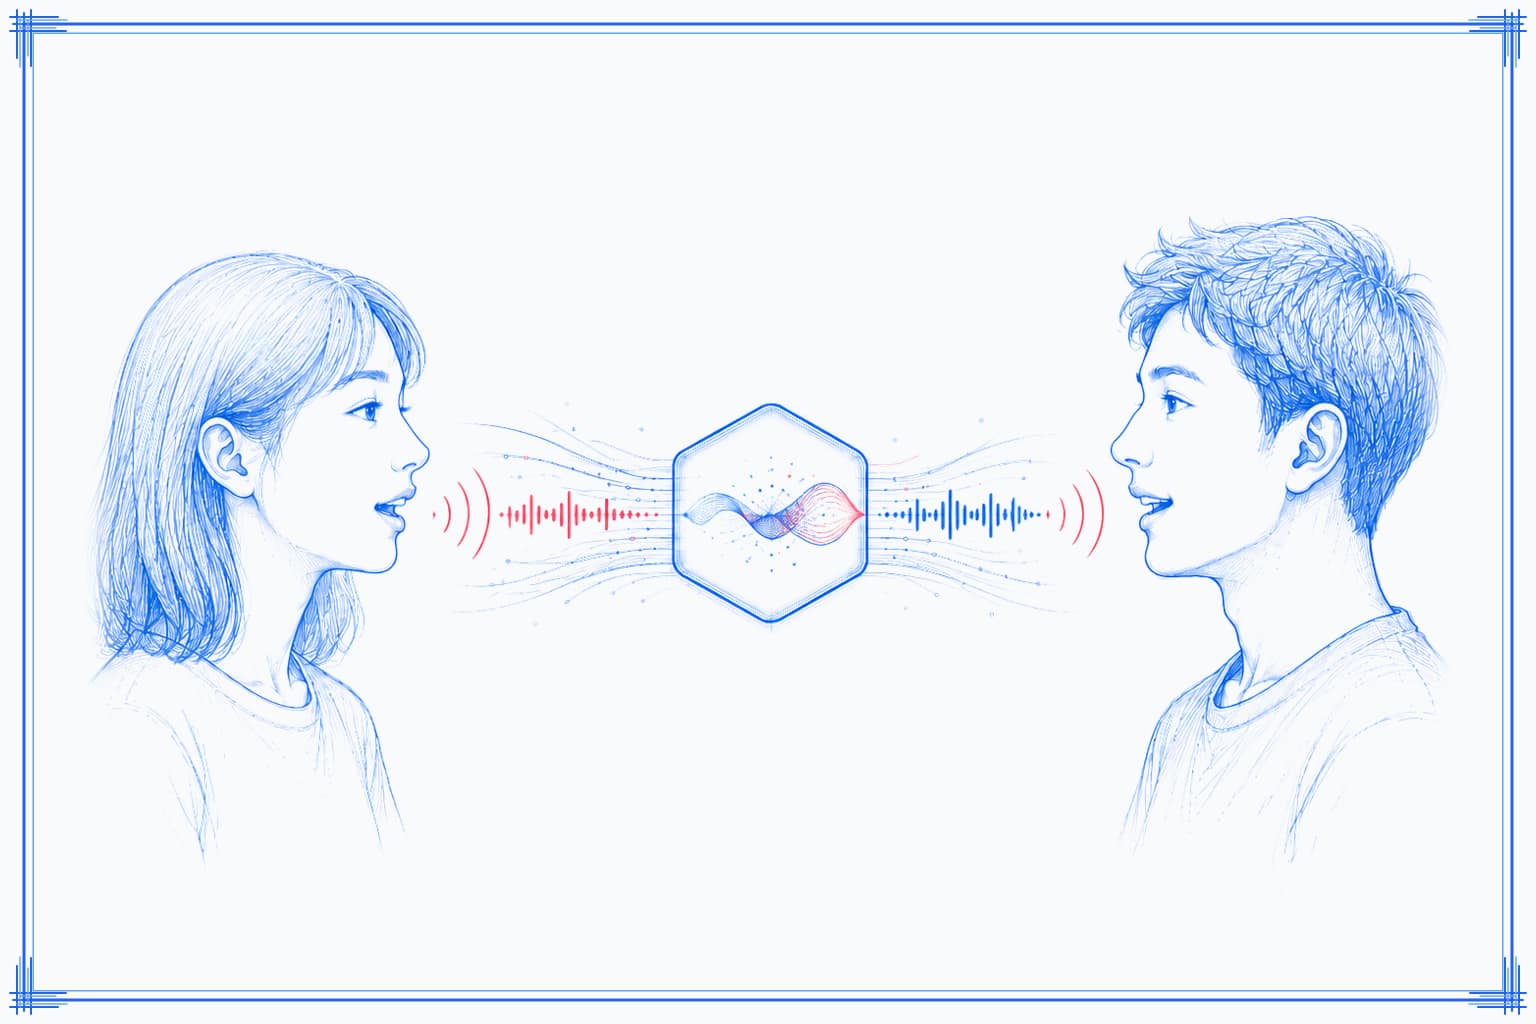
食べると、どんな言葉でも理解して会話できるようになる翻訳道具。
音声認識、機械翻訳、音声合成、ストリーミング処理を統合した会話翻訳は現実に利用できる。
ACT 1 / DISCOVER
いま、どこまで実現している?
空想の道具を原作どおりに使うための条件と、現代技術で到達している状態に分けて確認します。
総合実現スコア上の未達 30
原作どおりに使うための条件
道具を食べること。
あらゆる言語の理解と会話
摂取者が未知の言語を理解し、自分の言葉も相手に通じるようにする。
- 現在の状態
- 部分実現
- 実現度
- 70%
リアルタイム音声翻訳は実用化しているが、摂取型で知覚・発話能力そのものを直接変える機能は未実現。
ACT 2 / UNDERSTAND
総合実現スコア 70 の現在地を、6つの評価軸で見る
6つの評価軸を100点換算し、この道具と公開中の未来道具全体平均を比較します。
基本機能と技術成熟度を6つの評価軸で見ると、最大の未達は機能再現度です。完全実現には、測位性能そのものに加えて、社会で安全に使うための運用設計が重要になります。 神経介入や摂取型デバイスでは生体適合性、長期作用、回収性が重大課題。 会話音声、位置、話者識別、個人語彙が外部処理される場合の保護が必要。
レーダーチャートは各評価軸を100点換算して比較表示しています。総合実現スコアの配点は評価軸ごとに異なります。
- 機能再現度
- 25 / 35換算 71.4% / 平均 48.9%
- 技術成熟度
- 16 / 20換算 80% / 平均 64.7%
- 原作機能の利用可能性
- 9 / 15換算 60% / 平均 47%
- 精度・安定性
- 6 / 10換算 60% / 平均 50.5%
- 導入現実性
- 7 / 10換算 70% / 平均 52.1%
- 社会実装可能性
- 7 / 10換算 70% / 平均 56.3%
平均との差が最も大きいのは機能再現度。一方、原作機能の利用可能性は相対的に低く、完全実現に向けた課題として残ります。
Snapshot: 2026-09-04T22:44:17+00:00 / dataset 19 / schema v1.2
Technology Map
どんな技術が、この未来を支えている?


シームレスストリーミング
多言語音声を低遅延で連続翻訳し、会話時の言語障壁を下げる。
- 似ている点
- 音声をリアルタイムに近い形で別言語へ変換し、主要な会話翻訳機能を近似する。
- 違う点
- 外部機器と計算基盤が必要で、摂取による恒常的な言語理解ではない。
追加の技術解説
SeamlessM4T / SeamlessStreaming
音声・テキスト間の多言語翻訳と音声認識を単一系統で扱う多言語モデル群。
Whisper
多言語音声認識と言語識別、英語への音声翻訳を行う音声モデル。
GPT-Realtime-Translate
低遅延の多言語音声体験を構築するためのリアルタイム翻訳モデル。
Build Path
完全実現するなら、どう作る?
イヤホン、スマートフォン、クラウド翻訳を組み合わせた双方向リアルタイム通訳。
主要言語間で、相手の発話を理解し自分の発話を翻訳して返す。
安全な非侵襲または低侵襲の神経インターフェースで、意味表現を直接補助する。
音声を介さず言語理解・発話支援に近づく可能性。
追加で必要な技術条件
- 低資源言語でも高精度な同時通訳
- 端末内で動く省電力多言語モデル
- 文脈・文化・話者意図を保持する意味表現
- 安全で可逆的な神経言語インターフェース
Bottlenecks
完全実現まで、あと何が足りない?
ここでは点数の内訳ではなく、完全実現に向けて残る未解決課題を定性的に整理します。
技術課題
- あらゆる言語への対応 低資源言語、方言、混在言語、非言語情報を含めて均一品質を保証できない。
- 意味と文化の忠実な保持 皮肉、婉曲表現、専門語、固有文化の含意をリアルタイムで正確に移す必要がある。
- 生体内での直接理解 意味表現を脳へ安全に書き込み、発話意図を読み出す技術は基礎研究段階。
安全性
神経介入や摂取型デバイスでは生体適合性、長期作用、回収性が重大課題。
コスト
商用API利用料、端末、低資源言語データ整備、個人適応のコストがかかる。
プライバシー
会話音声、位置、話者識別、個人語彙が外部処理される場合の保護が必要。
低資源言語のゼロショット高精度化
少量データでも方言や希少言語を安定して認識・翻訳する学習法。
文化・意図・長期文脈の保持
単語置換ではなく、話者意図、皮肉、文化背景、会話履歴を安全に保持して訳す。
Technology Evolution
技術の歩みと実現への道
Technology Timeline
リアルタイム音声翻訳の技術年表
確認済み事実
多言語音声認識から同時通訳モデルまで
-
01製品化 確認済み 高 出典 1件
Whisper公開
大規模な多言語・多タスク学習による音声認識と英語翻訳モデルが公開された。
-
02研究 確認済み 高 出典 1件
SeamlessM4T発表
音声・テキスト間の多言語翻訳を統合したモデルが発表された。
-
03研究 確認済み 高 出典 1件
SeamlessM4T査読論文
最大100言語規模の音声・テキスト翻訳能力が査読論文として報告された。
-
04製品化 確認済み 高 出典 1件
低遅延リアルタイム翻訳モデル
会話中の低遅延多言語翻訳を構築するモデルが公式に紹介された。
Realization Roadmap
編集部予測ほんやくコンニャク実現ロードマップ
端末型の代替実現から神経直接支援まで
主要言語の端末型リアルタイム翻訳は実用段階。万能性と脳内直接理解は未実現。
-
01製品 可能性が高い 予測総合実現スコア 78 信頼度 75%
主要言語の常時オンデバイス通訳
通信なしでも主要言語を低遅延で双方向翻訳できる小型端末が普及。
必要なブレークスルー
- 低資源言語のゼロショット高精度化
予測根拠
既存のストリーミング翻訳と端末推論の延長。
-
02技術 実現可能性あり 予測総合実現スコア 88 信頼度 55%
低資源言語を含む高品質翻訳
方言・混在言語・文化的含意を含め、多数言語で安定した会話翻訳を実現。
必要なブレークスルー
- 低資源言語のゼロショット高精度化
- 文化・意図・長期文脈の保持
予測根拠
多言語表現学習の拡大は進むが、データ不足と評価が制約。
-
03技術 不確実 予測総合実現スコア 94 信頼度 25%
安全な言語神経支援
限定用途で、発話意図や意味理解を補助する可逆的な神経インターフェースを実証。
必要なブレークスルー
- 可逆的な神経言語インターフェース
予測根拠
現在は意味表現の一般化、安全性、個人差が大きな障壁。
ロードマップは、現在の研究・製品・社会動向を基にした編集部予測です。将来の実現を保証するものではありません。
Future Breakthroughs
実現に必要なブレークスルー
低資源言語のゼロショット高精度化
少量データでも方言や希少言語を安定して認識・翻訳する学習法。
文化・意図・長期文脈の保持
単語置換ではなく、話者意図、皮肉、文化背景、会話履歴を安全に保持して訳す。
可逆的な神経言語インターフェース
言語理解・発話意図を個人別に読み書きし、侵襲と副作用を最小化する。
ACT 3 / IMAGINE
この未来が実現したら、何が変わる?
端末型の万能翻訳機は進歩が速く、対応言語・遅延・自然さは改善する。一方、摂取型で脳の言語能力を直接変更する実現時期は見通せない。
- あらゆる言語の理解と会話が日常の選択肢になります
会話音声、位置、話者識別、個人語彙が外部処理される場合の保護が必要。
Current Experience
現代で近づけるもの
Current Experience
現代で体験できる近い商品
原作の体験そのものではありませんが、いま利用できる商品から近い体験を補足します。
※画像はイメージです POCKETALK S2 Plus ↗
現代の商品で近い機能や体験を試すに近い体験として参照できます。
Related Approaches
同じ技術で近づく道具
共通する技術をもとに、同じアプローチで実現に近づく道具を紹介しています。
Organizations
関連企業・研究機関
関連技術・エコシステム
シームレスストリーミングを通じて関連
Evidence & Sources
根拠資料と調査情報
Seamless Communication
SeamlessM4T v2とストリーミング音声翻訳の公式研究概要。
Introducing Whisper
多言語音声認識・翻訳モデルWhisperの公式紹介。
Advancing voice intelligence with new models in the API
低遅延音声認識とリアルタイム多言語翻訳モデルの公式紹介。
Joint speech and text machine translation for up to 100 languages
SeamlessM4Tの多言語・多モーダル翻訳能力を報告した査読論文。
Brain–machine-interface device translates internal speech into text
脳活動から内部発話をテキストへ変換する研究の解説。神経言語インターフェースの初期段階を示す。